ERD-DIAGRAMME, DIE NICHT VERALTEN
14. Januar 2026
Dokumentation, die sich nicht automatisch prüfen lässt, ist keine Dokumentation - sondern eine Behauptung. Ein Muster gegen veraltete Diagramme.
Die Ausgangslage
Ein Schema-Diagramm ist Dokumentation mit Verfallsdatum — nur steht das Datum nirgends drauf. Es stimmt am Tag der Erstellung, und ab da ist offen, wie lange noch.
Das ist kein Disziplinproblem. Es liegt an den Werkzeugen: Ein Diagramm, dessen Erzeugung mehr voraussetzt als das Repository selbst, lässt sich nicht in den normalen Entwicklungsablauf einbauen. Genau das haben wir uns bei der Arbeit an unserem eigenen Tooling genauer angesehen — und dabei ist erdify entstanden.
Das Tool ist dabei die kleinere Hälfte der Geschichte. Interessanter ist der Mechanismus dahinter, denn er betrifft genauso API-Dokumentation, Architekturdiagramme und Onboarding-Guides.
Warum Diagramme veralten
Der Grund ist strukturell.
Jeder etablierte ERD-Generator braucht eines von zwei Dingen: eine laufende Datenbankverbindung oder eine importierbare Anwendung. Beides ist lokal auf dem Entwicklungsrechner kein Problem. Beides ist überall dort unpraktisch, wo das Diagramm tatsächlich automatisch aktualisiert würde:
- Ein CI-Job hat keine Datenbank. Eine hochzufahren, nur um ein Bild zu zeichnen, steht in keinem Verhältnis.
- Eine Doku-Pipeline sollte nicht deinen kompletten Dependency-Baum installieren müssen.
- Wer ein Repository reviewt, das er gar nicht installieren kann, bekommt überhaupt nichts.
Also bleibt die Neugenerierung ein manueller Schritt. Und ein manueller Schritt, der nichts blockiert, konkurriert dauerhaft mit allem anderen auf dem Board. Nicht das Team ist hier das Problem, sondern der Umstand, dass das Aktualisieren nie im Pfad eines Commits lag.
Das Diagramm als Build-Artefakt
Die Lösung besteht darin zu ändern, woraus das Diagramm abgeleitet wird. Nicht aus einer Datenbank und nicht aus einer laufenden Anwendung, sondern aus den Model-Quelldateien — also genau aus den Dateien, die die Änderung selbst anfasst.
Dieser eine Schritt verändert die Ökonomie. Wenn ein Diagramm von allem erzeugt werden kann, was das Repository lesen kann, dann kann es auch von CI erzeugt werden, von einem pre-commit-Hook, von einem Doku-Build. Und was automatisch erzeugt werden kann, kann auch automatisch geprüft werden.
Genau dafür haben wir erdify gebaut. Es parst Model-Dateien mit dem ast-Modul der Python-Standardbibliothek — es importiert deinen Code nie und öffnet nie eine Verbindung. Deshalb hat es auch keine Runtime-Dependencies:
uvx erdify ./src/database -o docs/erd.pumlKein Setup, keine Installation ins Projekt, keine Datenbank. Das Tool liest Dateien, mehr nicht.
Der Drift-Check in CI
Der Generator ist austauschbar. Das Muster nicht:
erdify ./src/database -o docs/erd.puml --check
--check erzeugt das Diagramm im Speicher, vergleicht es mit der committeten Datei und beendet sich mit einem Fehlercode, wenn beide auseinanderlaufen. Es wird nichts geschrieben und nichts gepusht.
Hängt das in der CI, scheitert ein Pull Request, der ein Schema ändert, ohne das Diagramm mitzubringen. Die Entwickler:innen generieren neu, committen, und das Diagramm landet im selben Pull Request wie die Migration, die es ausgelöst hat — wo Reviewer:innen beides zusammen sehen können.
Dieser letzte Punkt ist der entscheidende. Die naheliegende Alternative — ein Bot, der das Diagramm neu generiert und in den Default-Branch committet — wirkt bequemer, verschiebt das Problem aber nur: Die Änderung landet ungereviewt auf dem Hauptbranch, und falls der Lauf einmal ins Leere greift, ersetzt er ein gutes Diagramm durch ein leeres. Lautlos, und mit grünem Haken.
Für ein Diagramm, das direkt in einer Markdown-Datei steckt — also dort, wo es tatsächlich gelesen wird — funktioniert dasselbe Gate:
erdify ./src/database --inject README.md --check--inject schreibt das Diagramm zwischen zwei Marker-Kommentare und fasst den Rest der Datei nicht an. Als Mermaid, das GitHub und GitLab nativ rendern — das Diagramm liegt also im Pull Request und nicht in einem Anhang.
Wer lieber vor dem Push absichert, nimmt den Hook:
# .pre-commit-config.yaml
repos:
  - repo: https://github.com/devsuit-berlin/erdify
    rev: v0.14.0
    hooks:
      - id: erdify-check
        args: [./src/database, -o, docs/erd.puml]
Die Grenzen
Quellcode zu lesen statt ihn zu importieren hat einen Preis, und jeder ehrliche Text nennt ihn: Das Tool sieht nur, was in der Datei steht. Ein Model, das zur Laufzeit per type() zusammengebaut wird, ein Tabellenname aus einem berechneten Ausdruck, Felder, die in einer Schleife angehängt werden - alles unsichtbar.
Für die meisten Codebasen ist das kein Thema; für manche ist es ein K.-o.- Kriterium. Wenn dein Schema wirklich zur Laufzeit entsteht, ist ein importbasierter Generator das richtige Werkzeug. Wir schreiben das auch so in unserem Vergleich der Alternativen - inklusive der Fälle, in denen ein Konkurrenz-Tool die bessere Antwort ist.
Wir finden: Erst die Offenheit über solche Grenzen macht den Rest belastbar. Zu jeder Architekturentscheidung gehört die Frage, wo sie nicht trägt.
Der polyglotte Fall
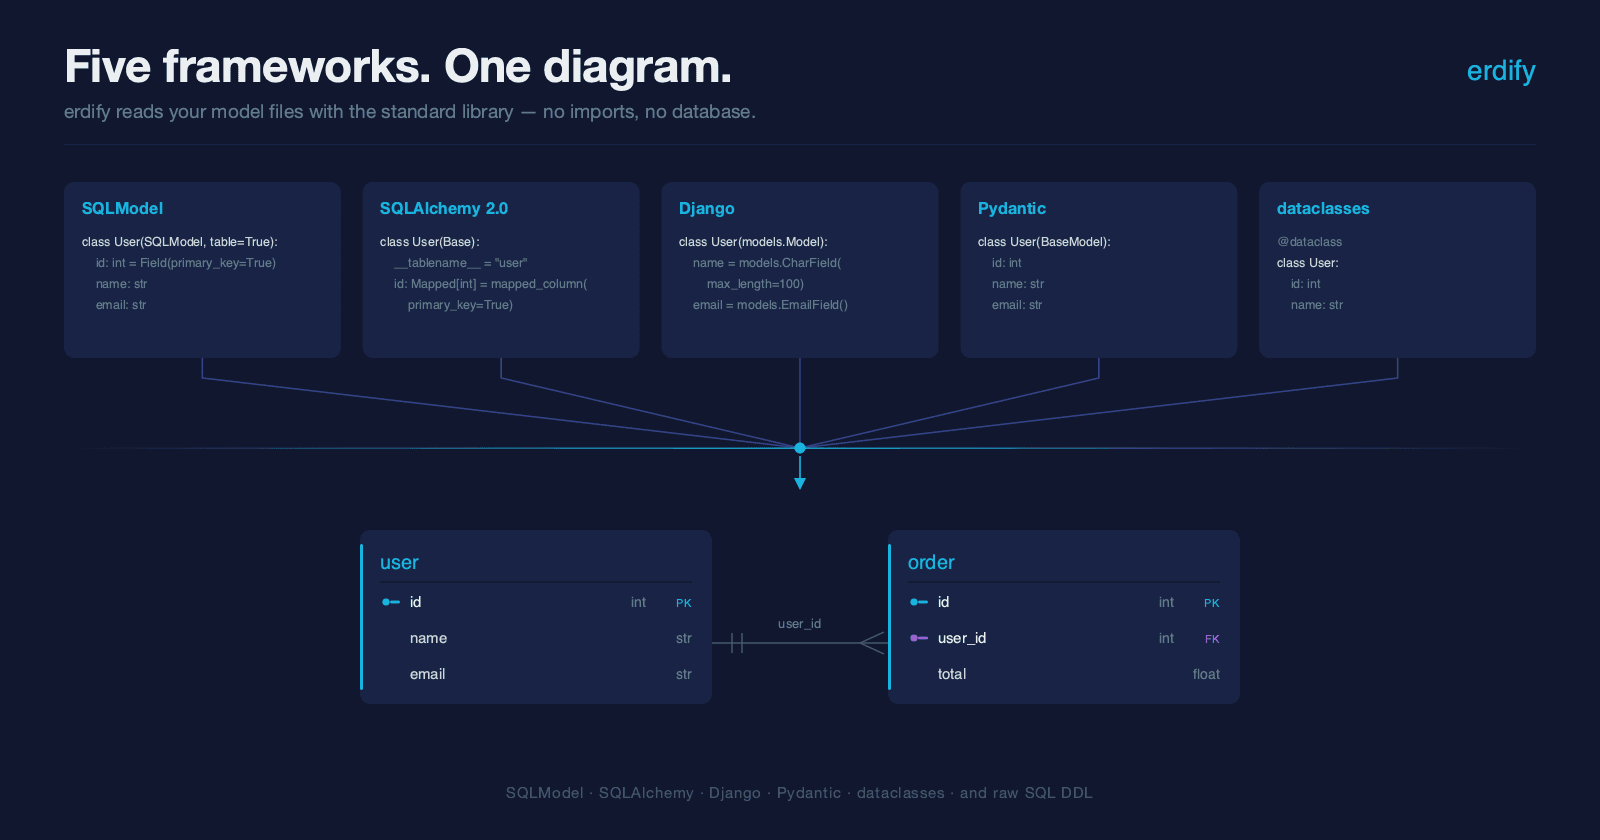
Richtig interessant wird das Thema in gewachsenen Systemlandschaften. Ein Django-Backend, ein FastAPI-Service auf SQLModel, ein internes Tool auf reinen Dataclasses, dazu ein schema.sql fürs Reporting — solche Kombinationen entstehen über Jahre und aus jeweils guten Gründen. Das Ergebnis sind trotzdem vier Schemas, vier Werkzeuge und vier Diagrammstile.
Quellcode statt Laufzeit zu lesen macht das handhabbar, weil der Parser nicht vier inkompatible Frameworks laden muss. Ein Befehl erzeugt ein Diagrammformat über alle hinweg — PlantUML, Mermaid, JSON oder eine eigenständige HTML-Seite.
Praktisch heißt das: Ein Repository, das du nicht einmal installieren kannst, lässt sich trotzdem dokumentieren. Für ein Review, eine Übernahme oder eine Due Diligence ist das der Unterschied zwischen „wir lesen uns durch den Code" und „wir sehen das Schema in zehn Sekunden".
Für Teams, die django-ninja einsetzen, gibt es seit Kurzem --base-classes: Basisklassen, die außerhalb der gescannten Dateien definiert sind (etwa ninja.Schema), lassen sich damit benennen und werden erkannt. Und .sql- Dateien liest erdify über das optionale Extra erdify[sql] direkt — das Analytics-Schema landet im selben Diagramm wie die ORM-Modelle.
Fazit
Du brauchst unser Tool nicht, um den Punkt mitzunehmen. Wenn in einem deiner Repositories ein Schema-Diagramm liegt, stell dir drei Fragen:
- Woraus ist es abgeleitet? Wenn die Quelle ein einzelner Arbeitsplatz ist, hängt die Aktualität an einer Person.
- Kann die CI es reproduzieren? Wenn nicht, wird es driften, und keine Disziplin der Welt verhindert das.
- Scheitert irgendetwas, wenn es driftet? Wenn nicht, ist der Drift unsichtbar — und nur der unsichtbare tut weh.
Es ist dasselbe Muster wie bei Basic Server Security: Die beste Absicherung nützt nichts, wenn niemand prüft, ob sie noch greift. Dokumentation, die sich nicht verifizieren lässt, ist keine Dokumentation. Sie ist eine Behauptung.
TL;DR
- Schema-Diagramme veralten, weil ihre Erzeugung eine Datenbank oder eine installierte Anwendung braucht — und damit nie automatisch läuft.
- Leite das Diagramm stattdessen aus den Quelldateien ab. Dann kann jeder Schritt, der das Repo lesen kann, es erzeugen.
- Erzeugbar heißt prüfbar:
--checklässt die CI scheitern, wenn Diagramm und Modelle auseinanderlaufen. - Gate im Pull Request schlägt Bot-Commit auf den Hauptbranch — das Diagramm gehört in das Review, das es verursacht hat.
- Der Trade-off: Ein AST-Parser sieht nur, was im Quelltext steht. Zur Laufzeit gebaute Models sieht er nicht.
uvx erdify ./src/database -o docs/erd.puml          # erzeugen
erdify ./src/database -o docs/erd.puml --check      # in CI prüfen
erdify ist Open Source unter der MIT-Lizenz, entwickelt und gepflegt von devsuit. Dokumentation: erdify.devsuit.io · Quellcode: github.com/devsuit-berlin/erdify
ERD-Diagramme
Datenbankmodellierung
Dokumentation
CI/CD
Python
Django
FastAPI
Open Source
Entwicklungsprozess
Code-Qualität

Fabian Clemenz
[email protected]